Mac miniで始める、ローカルLLM。
はじめに
手元のMacで文章を要約したり、メモを整理したりする。ローカルLLMを試そうとすると、モデル名やメモリ容量を調べる前に、一つ気になることがあります。そもそも、なぜMacが候補になるのでしょうか。
理由の一つは、CPUとGPUが同じメモリを使えることです。モデルの計算に使える容量を考えるとき、この仕組みが選択肢を広げます。その特徴を小さな据え置き機で使いたい人にとって、Mac miniは検討しやすい候補です。MLXのユニファイドメモリ解説、Mac miniの技術仕様
この記事では、まずMacとminiを選ぶ理由を整理します。その後、モデル名の読み方、必要なメモリ、待ち時間、構成と価格、最初の会話までを順に見ていきます。
本稿は2026年9月15〜16日の調査資料に基づく解説ガイドです。実機レビューではなく、導入手順も公式文書等をもとにしています。 製品仕様、作者の説明、公開された評価、計算例を区別して紹介します。
対象となるM6・M5 Pro搭載Mac miniは、日本では2026年8月25日に発表・予約開始、9月22日に届け開始・店頭発売の予定です。注文する構成の価格と納期は、購入時に確認してください。Apple日本の発表
この記事の順序
1. ローカルLLMは、手元で答えを計算する。
モデルとアプリを用意する
LLM(大規模言語モデル)は、学習した数値を使って、入力に続く文章などを計算するモデルです。Macで動かすときは、そのモデルと、実行を受け持つアプリを用意します。
たとえば、Qwenはモデルの系列名、LM StudioやOllamaはモデルを取得・管理して動かすアプリです。LM Studioをインストールした後、使うモデルをダウンロードし、会話できる状態へ読み込みます。Qwen3.5-4Bのモデルカード、LM Studioの基本手順
「ローカル」は、答えを作る計算を手元の端末で行うという意味です。
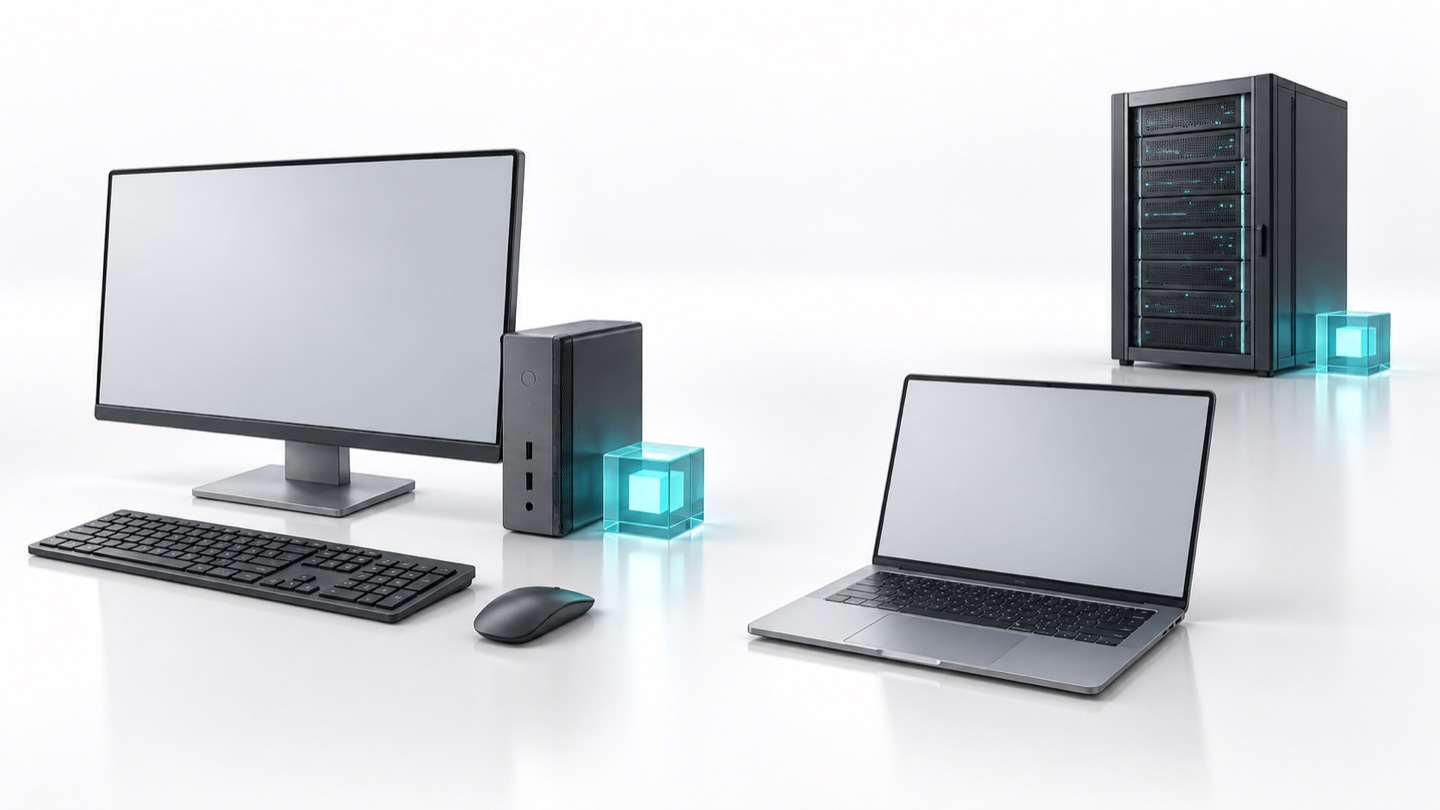
ローカルモデル手元の端末で計算
クラウドモデル外部サーバーで計算
答えを作る計算は、どこで行う?
青緑の立方体は、計算する場所を表す記号です。モデルの取得や更新、外部機能による通信は別に確認します。AI生成の概念CG
| 実行方法 | 入力から回答までの流れ |
|---|---|
| ローカルモデル | 入力 → Mac上のモデルで計算 → 回答 |
| クラウドモデル | 入力を送信 → 外部サーバー上のモデルで計算 → 回答を受信 |
表が収まらない場合は、横にスクロールできます。
LM Studioは、必要なモデルや実行用ソフトを取得した後のローカル推論を、オフラインで利用できると説明しています。モデル検索、ダウンロード、更新にはネット接続が必要です。また、クラウドモデルやWeb検索を選ぶと処理の範囲が変わるため、使うモデルと機能を確認します。オフライン利用、LM Studioのプライバシー説明
自分で答え合わせできる用途から始める
最初の課題には、短いメモの箇条書き化、文章から日付を拾う作業、数段落の要約などが考えられます。原文と回答を照合できる課題なら、文章が自然かどうかに加え、内容を落としたり付け足したりしていないかも確認できます。
これは試す用途の例です。手元で計算することが、回答の正しさを保証するわけではありません。使いたい作業について、内容が合うか、待ち時間を受け入れられるか、必要なメモリに収まるかを分けて確かめます。
なお、通常のチャットで行う「推論」は、学習済みの数値を使う処理です。会話の履歴を参照することと、モデルの数値を学び直すことも区別してください。LM Studioの会話管理、推論の技術解説
2. なぜMacが候補になる?
CPUとGPUが、同じメモリにアクセスできる
CPUはアプリの制御や対応する計算を、GPUは多数の計算を並行して行う処理を担います。ローカルLLMでは、対応した実行ソフトがGPUを利用します。そのときに重要なのが、モデルをどのメモリへ置くかです。llama.cppのCPU・Metal実行経路
一般的な独立GPU搭載PCでは、CPU側のメインメモリ(RAM)と、GPU側の専用メモリ(VRAM)が分かれています。Apple silicon Macのユニファイドメモリは、CPUとGPUが同じ物理メモリを使う構成です。MLXはこの共有構造を利用し、同じデータをCPUとGPUから扱えます。NVIDIAのホスト・デバイス間転送の説明、MLXの共有メモリ解説
独立GPU搭載PC通常のPCIe接続
必要なデータの転送
通常はPCIe経由
GPU担当の重み・KVキャッシュ・作業領域など。CPUとGPUの併用も、実行ソフトにより可能です。
Apple silicon MacCPUとGPUで共有
OSや作業用の余地も必要です。搭載RAM全体を、モデル専用として使えるわけではありません。
PCはRAMとVRAMの配置と分担を、
Macは共有メモリの中で使える量を考えます。
容量・図の面積・矢印の長さは比例表示していません。統合GPU搭載PCなどはこの比較の対象外です。GPUに重みを保持するPCでも、毎トークン重み全体を送り直すわけではありません。Macにもメモリの読み出し・同期・一時領域が必要です。
2026年9月15〜16日の調査資料に基づく独自図。出典:MLXの共有メモリ、NVIDIAの転送・データ保持、Metalの推奨作業領域、llama.cppの混合実行
| メモリの構成 | CPUが使う領域 | GPUが使う領域 | モデルを考えるときの要点 |
|---|---|---|---|
| PCIe接続の独立GPUを搭載したPC | メインRAM | GPUのVRAM | それぞれの容量と、どの処理をどちらへ置くかを考える |
| Apple silicon Mac | ユニファイドメモリ | CPUと同じ物理メモリ | OSやほかのアプリと共有する中で、モデルに使える量を考える |
表が収まらない場合は、横にスクロールできます。
メモリの関係を示す概念比較です。統合GPUを持つPCなど、すべてのPCが上段の構成に当てはまるわけではありません。
たとえばPCに64GBのRAMと16GBのVRAMがあっても、「GPUが同じ速さで使える80GBのメモリ」として足すことはできません。モデル全体をVRAMへ置くなら、その領域に収める必要があります。llama.cppのようにCPUとGPUを併用できるソフトもあるため、VRAMを超えた時点で実行方法がなくなるわけではありません。NVIDIAのメモリ転送の説明、llama.cppの混合実行
Macでは、CPU用とGPU用に物理容量が分かれていません。比較相手のVRAMより大きな領域を実際にGPU処理へ使える構成なら、モデルを保持できる容量の面で利点があります。 大きめのモデルを手元で試したいときに、ユニファイドメモリが注目される理由です。
共有メモリにも、OSと作業用の余地が必要
64GBのMacを選んでも、その64GBをすべてモデルの重みに使えるわけではありません。macOS、アプリ、計算途中の作業領域も同じメモリを使います。
AppleのMetal APIには、性能を保ちながらGPUが利用する作業領域の目安を示すrecommendedMaxWorkingSetSizeがあります。これは目安となる近似値で、搭載容量に対する一定割合や、絶対的な割り当て上限を意味しません。実際にモデルへ回せる量は、OSと実行ソフト、設定、併用する作業を含めて考えます。Metalの推奨作業領域、macOSのメモリ使用状況
容量に余裕があることと、回答が速いことも別です。GPUの演算性能、メモリ帯域、モデルの構造、実行ソフトが待ち時間に関わります。共有メモリを採用しているという理由だけで、独立GPU搭載PCより速いとは決まりません。LLM推論の速度を決める条件
転送を減らせる場面と、ソフトの対応を見る
CPUとGPUが同じデータを扱う場面では、MLXは別々のメモリへコピーする手間を減らせます。ただし、同期や一時領域まで不要になる仕組みではありません。MLXの共有メモリ解説
独立GPUでも、モデルをVRAMへ読み込んで保持できるなら、毎トークン、重み全体をCPU側から送り直す必要はありません。初回の読み込み、CPUとGPUを併用する計算、メモリ間の移動を伴う実行を分けて考えると、転送の説明を読み違えずに済みます。デバイス上にデータを保持する設計、CUDA Unified Memoryのページ移動
Mac側には、GPUを使うための仕組みであるMetalや、Apple silicon向けのMLXがあります。llama.cppもmacOSでMetalを利用できます。一方、NVIDIA GPU向けのTensorRT-LLMなど、GPUやOSを指定するソフトもあります。先に使いたいソフトが決まっている場合は、その対応環境から選ぶのが確実です。llama.cppのMetal対応、MLX、TensorRT-LLMの対応表
Macの利点が生きるのは、必要なモデルを保持できるメモリを選び、Macで対応する実行ソフトを使える場合です。すでに目的を満たすMacやGPU搭載PCがあるなら、買い足す前にその環境で小さな課題を試すところから始められます。
3. Macの中で、miniを選ぶ理由。
机に置く小さな本体と、使い回せる周辺機器
ユニファイドメモリは、miniだけの特徴ではありません。Macの中でminiを選ぶ理由は、据え置きで使う条件と本体構成にあります。
Mac miniの外形は幅12.7cm、奥行き12.7cm、高さ5.0cm。Mac Studioは幅19.7cm、奥行き19.7cm、高さ9.5cmです。机上の本体寸法を抑えたいとき、miniのサイズは分かりやすい違いになります。設置するときは本体に加え、ケーブルと通風の場所も確保します。Mac miniの寸法、Mac Studioの寸法
上から見た外形
横から見た高さ
外形寸法を同じ縮尺で示した独自の模式図です。実物写真ではありません。設置にはケーブルと通風の場所も必要です。図は必要な設置余白を表していません。
2026年9月15〜16日確認。出典:Mac miniの技術仕様、Mac Studioの技術仕様
miniにはHDMI、Ethernet、Thunderboltがあり、ディスプレイや入力機器を組み合わせて使います。同梱物は本体と電源コードなので、すでに使えるモニター、キーボード、マウスがある人は、その環境を生かせます。初めて一式をそろえる人は、周辺機器も予算に入れてください。接続端子と同梱物
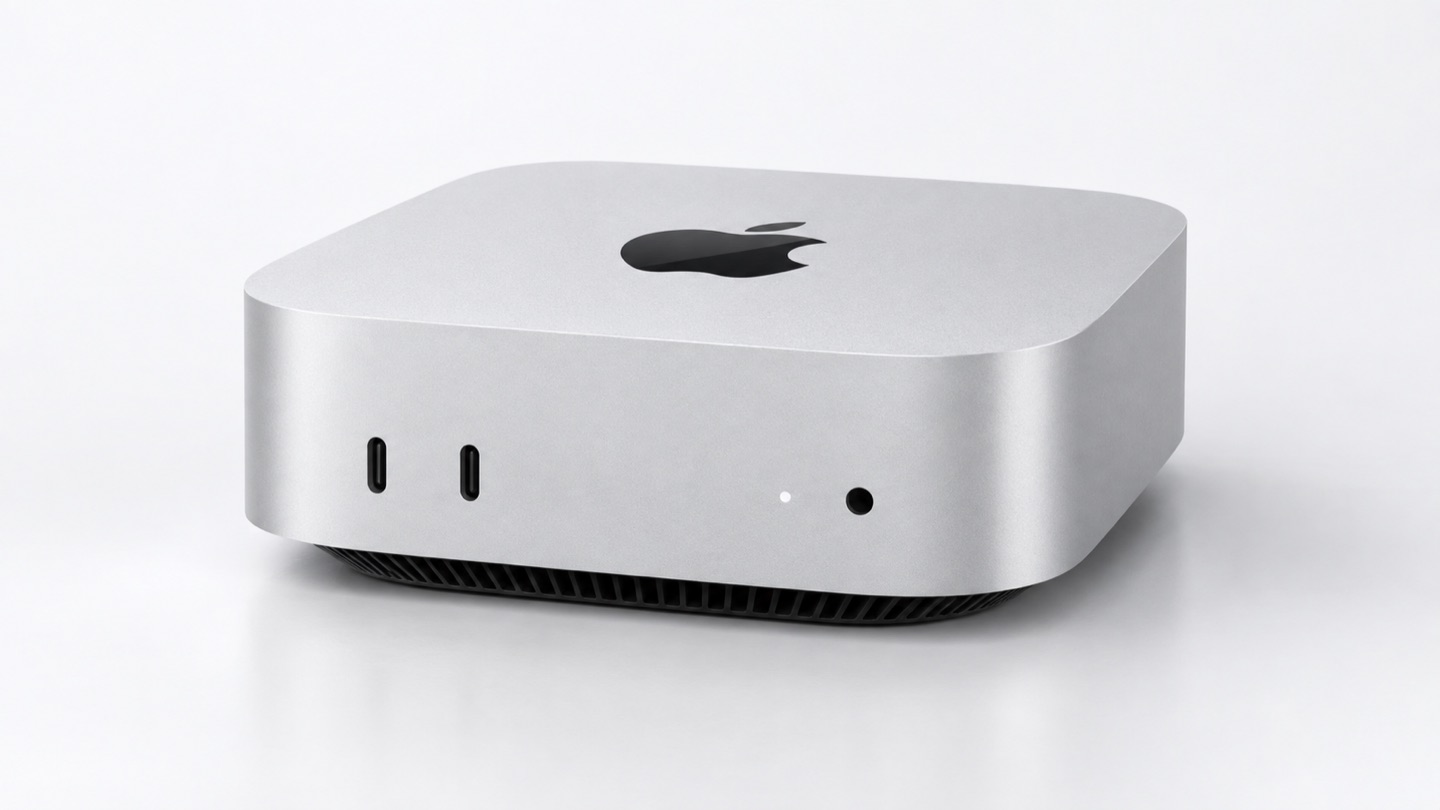
Mac miniの外観イメージ。
Appleの公式画像を参考に生成したCGです。実機写真ではなく、形状や細部は実物と異なる場合があります。AI生成CG
持ち運ぶ必要があるかで、本体価格の意味が変わる
16GBメモリ・512GB SSDの本体価格を比較すると、次のようになります。
| 機種・構成 | 日本の通常税込価格 | 確認方法 |
|---|---|---|
| Mac mini M6・12CPU/12GPU・16GB/512GB | 185,800円 | 公式開始価格149,800円にSSD増額36,000円を加算 |
| MacBook Air 13インチ M5・10CPU/8GPU・16GB/512GB | 224,800円 | 公式価格表示 |
表が収まらない場合は、横にスクロールできます。
2026年9月15日の確認情報です。miniには周辺機器代を含めず、教育価格、下取り、AppleCare等も含めていません。Mac miniの構成画面、MacBook Airの購入画面、MacBook Airの仕様
差額は計算上39,000円です。ただし、チップや筐体は異なり、Airには画面、キーボード、バッテリーがあります。持ち運びたい人にはAirの一体型の構成に意味があり、自宅のモニターで使う人にはminiの本体価格が判断材料になります。これは同じLLM性能を同じ費用で比較した結果ではありません。
miniを候補にする条件を整理する
- 机で使う。 画面や入力機器を自分で組み合わせ、持ち運ぶ必要が少ない。
- 必要なメモリを選ぶ。 M6の16・24・32GB、M5 Proの24・48・64GBという選択肢から、実行時の必要量を考える。
- 使うアプリがMacに対応する。 LM Studioなどで始めるか、必要な実行環境を先に確認する。
メモリの選択肢はAppleの公式仕様に基づきます。より大きな容量を検討する場合はMac Studioも候補になり、同じ48GB・64GBでの価格比較は6章で扱います。Mac miniのメモリ構成、Mac Studioのメモリ構成
逆に、今使っているクラウドAIで用が足りていて、手元で実行する具体的な用途がまだないなら、専用機を急いで買う必要はありません。機種選びを進める前に、扱いたい文章と作業を一つ決めると、必要な容量の話へ進みやすくなります。
4. モデル名を読み、試す一つを決める。
「4B」と「Q4」は、別の情報
今回の導入候補は、次のファイルです。
Qwen_Qwen3.5-
| 表記 | 意味 |
|---|---|
| Qwen3.5 | モデルの系列 |
| 4B | 言語モデル部が約40億パラメータという作者の公称 |
| Q4_K_M | 数値の表現を小さくする量子化方式の名前 |
| .gguf | モデルファイルの形式 |
表が収まらない場合は、横にスクロールできます。
パラメータは、学習で調整された数値です。Bは10億を表し、モデルの規模を見る手掛かりになります。4Bという名前からファイルが4GBだとは判断できず、回答品質の点数として読むこともできません。Qwen3.5-4Bの作者による説明、対象GGUFファイル
量子化は、数値を少ない情報量で表す手法です。保存やメモリの負担を抑えられますが、品質と速度への影響は方式や実装で変わります。Q4_K_Mも全要素を一律4bitにするという意味ではありません。同じ「4bit」という説明でも、形式や配布者まで確認します。QwenのGGUF配布、bartowskiの変換配布、MLX版の量子化設定
モデル学習済みの数値を持つデータ
実行アプリモデルを読み込み、動かす
アプリとは別に、使うモデルを選ぶ。
ガラス板はモデルのデータを表すたとえです。板の枚数や大きさは、容量や回答品質を示していません。モデルの系列・規模・量子化・形式を分けて確認します。AI生成の概念CG
会話の長さは、トークンで数える
文章は、モデルが処理する単位である「トークン」に分けられます。文字数とは一対一に対応せず、同じ日本語でもモデルの分割方法によってトークン数は変わります。トークン化の解説
「コンテキスト」は、一度に参照する文脈の範囲です。アプリで設定する文脈長には、貼り付ける資料に加えて、指示、会話履歴、生成する内容も関係します。長い資料を扱うときは、直前の質問だけを数えても足りません。会話とコンテキストの管理、文脈長の説明
作者が示す最大文脈長、アプリに設定した長さ、実際に使うトークン数は、それぞれ別です。最初からモデルの上限まで設定せず、必要な長さから始めます。
小さいファイルから、用途との相性を見る
比較の入口として、Qwenの次の配布ファイルを取り上げます。規模と構造は作者の公称、容量は量子化ファイルの配布表示です。
| 元モデルID | 構造・言語モデル部の規模 | 対象Q4_K_Mの掲示容量 | 配布者・対象ファイル |
|---|---|---|---|
Qwen/ |
Dense・4B | 約3.01GB | bartowski/Qwen_Qwen3.5-4B-Q4_K_M.gguf |
Qwen/ |
Dense・9B | 約6.17GB | bartowski/Qwen_Qwen3.5-9B-Q4_K_M.gguf |
Qwen/ |
Dense・27B | 約19.0GB | ggml-org/Qwen3.8-27B-Q4_K_M.gguf |
Qwen/ |
MoE・総35B/活性3B | 約22.29GB | bartowski/Qwen_Qwen3.5-35B-A3B-Q4_K_M.gguf |
表が収まらない場合は、横にスクロールできます。
2026年9月15〜16日に確認した、テキスト用の対象ファイルです。容量は必要RAMの実測値ではなく、別配布の画像用・追加生成用の補助ファイル等も含めていません。35B-A3Bは配布カードで22.29GB、ファイル画面では丸めて22.3GBと表示されています。4B作者カード、9B作者カード、27B作者カード、35B-A3B作者カード
Denseは通常、各層の密な演算を使う構造です。MoEは「専門家」と呼ばれる一部の計算部分をトークンごとに選びます。35B-A3Bの活性3Bは、その処理で使う部分の規模であり、保存する全体が3B分になるという意味ではありません。約22.29GBのファイル容量を見れば、計算に使う部分と保持する全体を分ける必要が分かります。MoEの作者説明、配布ファイル
最初の候補には約3.01GBの4Bを使い、ロードと短い指示を確かめます。そこで用途に足りない点が見えたら、同じ原文と指示で9Bなどを比べます。大きいファイルを選ぶこと自体を目的にせず、要約の抜け、日付の抽出、指定した項目数など、自分が必要な条件を見る進め方です。
日本語の評価は、何を試した結果かを見る
Qwen3.5の作者は201言語・方言への対応を掲げています。一方、日本語の課題をどの程度こなせるかは、課題と配布ファイルをそろえて判断する必要があります。作者の多言語対応の説明
第三者の公開資料には、M1 MacBook Pro 8GB・macOS Sequoia・Ollama 0.20.0での日本語要約例があります。また、M4 Mac mini 16GB・llama-serverで、今回と同じ配布者・ファイル名を扱った報告もあります。前者は別のOllama配布、後者は日本語要約の試験ではなく、どちらも今回の固定ファイルとの完全な照合条件はそろっていません。各環境での動作報告として読めます。ElcamyのM1での動作報告、M4 miniでの測定報告
日本語の会議文を扱うJ-MeetEvalには、元モデル名Qwen3.5-4Bの指示追従評価もあります。ただし、合成会議を対象とし、ルールと別のLLMで判定した課題別の評価です。評価者は自社モデルも比較しており、今回の固定GGUFを測った結果とは確認できません。数値をそのまま「このファイルの日本語品質」に置き換えず、要約・抽出・形式指定を自分の課題で確かめる参考にします。J-MeetEvalの評価方法と結果
各モデルカードのライセンス表示はApache-2.0です。利用時は選んだ配布物とアプリの条件を確認し、ファイルを再配布する場合はLICENSEやNOTICEも確認してください。4Bのモデルカード、9Bのモデルカード、27Bのモデルカード、35B-A3Bのモデルカード
5. 必要なメモリを、分けて考えよう。
モデル以外にも、実行中の置き場がいる
SSDはモデルを保存する場所、RAMは実行中のデータを扱う場所です。LM Studioでも、ダウンロードとロードは別操作になっています。モデルを何本保存できるかと、どのモデルをどの条件で動かすかを分けて考えます。モデル取得と読み込み
実行時のメモリは、おおむね次の内訳になります。比率を測った図ではなく、必要な領域を整理するための表です。
ほかの作業
領域の種類を並べた図で、面積は使用量や比率を示していません。下の表で、それぞれの役割と増える条件を確認します。
出典:KVキャッシュ、LM Studioのメモリ推定、macOSのメモリ使用状況。2026年9月15〜16日確認。
| メモリを使うもの | 役割・増える条件 |
|---|---|
| モデルの重み | 学習済みの数値。モデルと量子化方式で容量が変わる |
| KV/状態キャッシュ | 過去の計算結果を再利用する領域。文脈や並列会話、構造で変わる |
| 計算中の作業領域 | 実行ソフトが一時的に使う領域。処理や設定で変わる |
| macOS・アプリ・ほかの作業 | Mac全体を動かす領域。ブラウザーなどの併用分も必要 |
表が収まらない場合は、横にスクロールできます。
KVキャッシュは、過去のトークンを参照するためのKとVという計算結果を保持する仕組みです。会話履歴のテキストファイルとは異なり、モデル内部のデータを保存します。会話が伸びたときの負担を、モデルの重みファイルだけでは説明できない理由の一つです。KVキャッシュの解説、Mac全体のメモリ使用状況
重みだけなら、簡単な概算ができる
重みの理想バイト数 = パラメータ数 × 1パラメータのbit数 ÷ 8
8Bの数値をすべて4bitにすると約4.00GB、すべて16bitなら約16.00GBです。これは全パラメータを同じ精度で表した計算例で、必要RAMの見積もり全体ではありません。
実際のQwen3-は約5.03GBと掲示されています。量子化の補助情報や異なる精度の部分などがあるため、単純計算とファイル容量は一致しません。さらに、実行時には上の表のキャッシュや作業領域を足して考えます。Qwen3-8Bの公式配布
単位にも注意が必要です。GBは10億バイト、GiBは1,073,741,824バイトなので、4.00GBは約3.73GiBです。アプリと仕様表の数字を比べるときは、表示単位をそろえます。
容量選びは、ファイル・文脈・併用作業の順に
まず、使いたいモデルの実ファイルを決めます。次に、どの長さの文章を扱い、同時にいくつの会話を動かすかを考えます。そのうえで、ブラウザーなど日常の作業を含めて余地を取ります。
たとえば約3.01GBの4Bと約19.0GBの27Bでは、重みを置く段階から条件が違います。27Bの対象ファイルを見て「16GBメモリへ全体を常駐させよう」とは計画できません。また、24GBからファイル容量を引いた残りを、そのまま会話に使える空きと見なすこともできません。GPUが使う領域やOS、キャッシュを含めた確認が必要です。4Bファイル、27Bファイル、GPUの推奨作業領域
LM Studioには、文脈設定などを含めて読み込み前にメモリ量を推定する機能があります。まず推定を見て、実行できたらアクティビティモニタでメモリプレッシャーやスワップの変化を見る。この二段階で、見積もりと実際の負担を分けます。LM Studioのメモリ推定、アクティビティモニタ
新型miniの購入画面では、ユニファイドメモリも内蔵ストレージも、購入後のアップグレードはできないと案内されています。購入時は、使うモデルと文脈からメモリを考え、次にOS・普段のデータ・モデルの保存先を含めてSSDを選びます。Appleのメモリ・ストレージ選択の説明
補足:文脈を伸ばすと、キャッシュはどう増える?
Qwen3-8Bだけを例に、KVキャッシュの部分計算をしてみます。公式設定の36層、KVヘッド8、ヘッド次元128を使い、KとVを各2バイトのFP16で保存すると仮定します。1会話で全層が全トークンを保持する条件です。ヘッド数と次元は、保存する数値の組数と一組の大きさを決める設定です。
KV bytes = 2(KとV)×36層×トークン数×8×128×2 bytes×1会話
| 保持トークン数 | 計算上のKV容量 |
|---|---|
| 4,096 | 0.5625GiB |
| 32,768 | 4.5GiB |
表が収まらない場合は、横にスクロールできます。
重み、計算用の一時領域、アプリ、OSを含まない概算です。実際の確保方式でも使用量は変わります。Qwen3.5/3.8は異なる注意機構を組み合わせた構造なので、この式と結果をそれらのモデルへそのまま当てはめることはできません。Qwen3-8Bの公式設定、キャッシュ方式の違い、Qwen3.5の構造、Qwen3.8の構造
6. 容量と速度から、構成を選ぶ。
待ち時間を分けると、見る仕様も変わる
メモリ容量のGBは、保持できる情報量です。メモリ帯域のGB/sは、1秒に転送できる情報量の指標です。モデルが収まる構成を考えた後は、どの処理の待ち時間が気になるかを見ます。
入力列を処理して生成の準備をする段階をprefill(入力処理)、通常はトークンを一つずつ生成する段階をdecode(出力生成)と呼びます。LLM推論の技術解説
prefill入力処理
入力列を処理し、
生成の準備をする。
decode出力生成
通常はトークンを
一つずつ生成する。
図の幅と記号の数は、所要時間や実際のトークン数を表していません。思考用のトークンが先に出る場合、最初のトークンと読める回答の始まりは一致しないことがあります。
出典:LLM推論の技術解説、Qwenの思考設定。2026年9月15〜16日確認。
| 気になる待ち時間 | 確認する条件 |
|---|---|
| モデルを開いて使えるまで | 保存先からの読み込み、初回か再ロードか |
| 質問を送ってから返答が始まるまで | 入力の長さ、prefill、ロード済みか、思考設定 |
| 返答の文章が伸びる間 | decodeのtokens/s、モデル・量子化、実行ソフト |
| 回答が最後まで出るまで | 思考と回答の長さ、停止条件、入力処理を含む全体 |
表が収まらない場合は、横にスクロールできます。
1会話のDenseモデルで逐次生成する場合、重みをメモリから読み出す処理が速度を制限することがあります。この条件では帯域が効きます。入力をまとめて扱うprefillでは演算性能が効きやすく、文脈長や並列数、モデル構造によっても制約が変わります。入力処理と逐次生成の違い
仕組みを単純化すると、帯域による生成速度の上限 ≈ 実効帯域 ÷ 1トークン当たりの転送量という関係になります。重みが常駐したDenseモデルを1会話で使い、先読み候補を使う投機的生成を行わない、といった条件を置いた理論上の関係です。実際にはキャッシュの読み書き、計算、実行の手間もあるため、公称帯域を重み容量で割って製品の実速度にすることはできません。
「最初のトークンまでの時間」はTTFTとも呼ばれます。思考用のトークンを先に出すモデルでは、読者が読める回答の始まりと一致しないことがあります。tokens/sだけで比較せず、同じ入力と出力条件で回答までの時間を見ると、用途に結び付けやすくなります。推論の指標、Qwenの思考設定、トークンと文字数
Neural EngineとGPU内のNeural Acceleratorsも別の回路です。AppleのM5向けMLX解説は、GPU内のNeural Acceleratorsを使う経路とmacOS 26.2以降の条件を示しています。回路名からLLMの速度を読み取るのではなく、使うアプリとランタイムがどの経路へ対応するかを見ます。AppleのMLX・M5実装解説
M6とM5 Proは、容量と帯域を別々に比べる
| チップ | CPU/GPUコア | メモリ選択肢 | 公称メモリ帯域 |
|---|---|---|---|
| M6 | 12/12 | 16GB | 153GB/s |
| M6 | 12/12 | 24GB、32GB | 170GB/s |
| M5 Pro | 15/16 または18/20 | 24GB、48GB、64GB | 307GB/s |
表が収まらない場合は、横にスクロールできます。
2026年9月15〜16日のApple日本の公式仕様です。帯域はLLMの生成速度の測定値ではありません。M6はメモリ構成によって公称帯域も変わるため、チップ名だけで比較しないようにします。Mac miniの技術仕様
SSDを512GBにそろえた本体価格は、次のとおりです。
| チップ・CPU/GPU | メモリ | 通常税込価格 | 確認方法 |
|---|---|---|---|
| M6・12/12 | 16GB | 185,800円 | 公式価格と増額から算出 |
| M6・12/12 | 24GB | 221,800円 | 公式価格と増額から算出 |
| M6・12/12 | 32GB | 257,800円 | 選択後の合計表示 |
| M5 Pro・15/16 | 24GB | 299,800円 | 公式開始価格・構成表示 |
| M5 Pro・15/16 | 48GB | 407,800円 | 選択後の合計表示 |
| M5 Pro・15/16 | 64GB | 479,800円 | 選択後の合計表示 |
表が収まらない場合は、横にスクロールできます。
日本・2026年9月15〜16日確認。すべて512GB SSDで、教育価格、下取り、AppleCare、追加ソフト、10Gb Ethernetへの変更、周辺機器は含めていません。開始価格149,800円のM6は16GB/256GBで、上表とはSSDが異なります。Mac miniの構成画面、日本の開始価格
24GB/512GB同士では、M6と15CPU・16GPUのM5 Proの差額は78,000円です。必要なメモリが同じなら、帯域や演算構成の違いを比較する組み合わせになります。
一方、M6の32GB/512GBとM5 Proの24GB/512GBは42,000円差です。こちらはProの方が帯域が大きく、メモリ容量は小さくなります。32GBという容量を必要として選ぶ場合に、Proという名前だけで24GBへ変更すると、目的と合わなくなります。差額はいずれも上表からの算術です。
48GB・64GBなら、Studioとも容量をそろえる
大容量のminiとStudioを比較するなら、開始価格だけでなく、メモリとSSDをそろえます。
| 機種・チップ・CPU/GPU | メモリ/SSD | 通常税込価格 | 公称帯域 |
|---|---|---|---|
| Mac mini M5 Pro・15/16 | 48GB/512GB | 407,800円 | 307GB/s |
| Mac Studio M5 Max・18/40 | 48GB/512GB | 527,800円 | 614GB/s |
| Mac mini M5 Pro・15/16 | 64GB/512GB | 479,800円 | 307GB/s |
| Mac Studio M5 Max・18/40 | 64GB/512GB | 599,800円 | 614GB/s |
表が収まらない場合は、横にスクロールできます。
日本・2026年9月16日の選択済み構成画面と公式仕様です。通常税込、教育価格・下取り・AppleCare・追加ソフト・周辺機器なし。標準Ethernetはminiが2.5Gb、Studioが10Gbで、端子を含む全仕様が一致する比較ではありません。両機種とも9月22日発売予定の予約表示です。Mac miniの購入画面、Mac Studioの購入画面、miniの仕様、Studioの仕様
この構成では、48GBも64GBもStudioが120,000円高い計算になります。必要な容量がこの範囲に収まり、本体価格や机上寸法を重視するなら、miniを選ぶ理由になります。Studioの帯域は公称で大きくなりますが、その比率から生成速度や差額に見合う効果までは決まりません。
Studio M5 Maxの40GPU構成には128GBの選択肢もあります。miniの最大64GBでは必要な実行予算を満たせない場合は、モデルや文脈を見直すか、こうした大容量構成を比較対象に加えます。Mac Studioのメモリ選択肢
構成を確認するときは、使うモデル、文脈長、併用する作業とともに、チップ・CPU/GPU・メモリ・SSDを書き留めておくと、容量の違う価格を混ぜずに済みます。Apple公式でMac miniの構成を確認する
7. LM Studioで、最初の会話へ。
主経路は、特定のGGUFを一つ選ぶ
ここからは、公式文書等に基づく導入手順です。調査時のアプリはLM Studio 0.4.24 build 1。新型miniで手順を完走した記録ではないため、実際の表示と対応ランタイムを確認しながら進めます。公式ダウンロード、0.4.24の更新情報
LM StudioではGGUFとMLXの両経路が案内されています。この記事は配布者、ファイル名、量子化を照合しやすい一つのGGUFを入口にします。GGUFに対応する別環境へ持ち出す場合にも、同じファイルを指定できます。MLXも同じアプリから選べるので、Python環境の手動構築が必須というわけではありません。Qwen3.5-4BのGGUF・MLX案内、モデルの検索・取得、llama.cppの対応環境
| 経路 | 配布物 | 選ぶ理由 |
|---|---|---|
| 今回の主経路:GGUF | bartowskiのQwen_Qwen3.5-、約3.01GB |
特定の一ファイルを照合して始める |
| 代替:MLX | lmstudio-、配布全体約3.06GB |
MacでMLXの実行経路を使う |
表が収まらない場合は、横にスクロールできます。
MLX版は重みのSafetensorsに加え、設定やトークナイザー等を含みます。4bit affine・group size 64という量子化で、GGUFのQ4_K_Mとは別の変換です。形式だけで速度や品質が同じとは扱わず、GGUFの拡張子を変えてMLXとして使うこともできません。GGUFの配布、MLXの配布と設定
手順1:アプリと保存先を準備する
LM Studioの公式ダウンロードからMac/Apple silicon向けを選び、公式案内に沿ってインストールします。公式の最低条件はmacOS 14以降とApple silicon、メモリは16GB以上推奨です。これはアプリの条件で、選ぶモデルの必要メモリとは分けて考えます。LM Studioをダウンロード、動作条件
保存先にはモデル本体に加え、アプリ、ランタイム、ダウンロード中の一時領域などの余地も用意します。ランタイムは、実際にモデルを計算する実行用ソフトです。アプリ本体とランタイムは版が別なので、新しいモデルを扱うときは両方を確認します。モデルの保存先、ランタイムの更新案内
手順2:Discoverで、配布者とファイルを合わせる
Discoverの検索に、次の配布リポジトリ名を入力します。
bartowski/
一覧でQwen_Qwen3.5-、約3.01GBを照合し、そのファイルを一つ取得します。Discoverはuser/形式やHugging FaceのURLからの検索を案内しています。Discoverでの検索方法、照合する対象ファイル
LM Studioの公式モデルカタログから案内されるlmstudio-配布は、このbartowski配布とは異なります。モデル名の4Bだけで同じものと判断せず、配布者とファイル名まで確認してください。公式モデルカタログ
手順3:Chatへ読み込み、短い会話の条件を設定する
Chatのモデルローダーから、取得したファイルを選びます。最初はテキストだけ、1モデル・1会話、文脈4,096トークンを確認の出発点にします。Chatでの読み込み
Qwen3.5-4Bの公式カタログには、Enable Thinkingの既定値がtrueと記載されています。Thinkingは、最終回答の前に思考用の生成を行う設定です。短い出力上限では、回答前に上限へ達する場合があります。Thinking設定、短い出力上限に関する公開報告
初回の出力上限256トークンという設定案は、選んだモデルでThinkingをOFFにでき、実際に反映されることを確認できる場合に使います。 カタログの設定が個別のインポートにも同じように適用されるとは限りません。設定を確認できない場合は、モデルのテンプレートとランタイムの対応を確認してから、この短い出力条件を試してください。
GPUへの計算の割り当てやキャッシュ設定を変更した場合は、その値も記録します。ロードに失敗したら、エラー内容とアプリ・ランタイムの版、対象ファイル、メモリ推定を照合します。ロード設定と推定
手順4:短い日本語を送り、内容と実行先を見る
試す入力の例です。
次の3項目を日本語で箇条書きにしてください。持ち物は傘、飲み物、ノートです。
回答が出たら、3項目がそろっているか、余計な持ち物を追加していないか、箇条書きになっているかを確認します。この入力は動作確認用に用意した例で、回答例や所要時間を実測したものではありません。
出てきた文章を、原文と見比べる。
抜けた項目や、勝手に足された内容がないかを確かめます。画像内の線は文章を表す記号で、実際の入力・生成結果ではありません。AI生成の確認場面CG
選択モデルが取得済みのローカルファイルであることと、クラウドモデル、Web検索、外部ツールを選んでいないことも確認します。必要なファイルをそろえた後、ネット接続を切った状態で同じ短文を試す方法もあります。これはオフラインで使えるかを確かめる方法であり、アプリ全体の通信監査とは別です。オフラインで使える範囲、外部機能とプライバシー
手順5:生成停止、ロード解除、削除を使い分ける
| 目的 | 操作の意味 |
|---|---|
| 今の回答を止める | 進行中の生成を停止する |
| モデルが使うメモリを解放する | モデルをロード解除する(Unload) |
| 保存先の容量を空ける | 不要なモデルファイルを削除する |
表が収まらない場合は、横にスクロールできます。
モデル削除の経路はMy Modelsで対象を確認する案内があります。削除する場合は名前と保存先を照合してください。会話履歴は別に管理されており、モデルを消す操作と履歴の削除を混同しないようにします。ロード解除の公式CLI、モデル管理の補助資料、会話履歴の管理
補足:ランタイムとモデルを切り分ける
CLIは、ターミナルから文字で操作する方法です。初回の会話に必須ではありませんが、LM StudioのCLIが使える場合は、次の公式コマンドが確認に役立ちます。
lms ls
lms load --estimate-only <model_key> --context-length 4096
lms unload <model_key>
<model_key>はlms lsに出る対象モデルの識別子へ置き換えます。-は読み込み前の推定で、起動保証や実測ピークRAMではありません。unloadは読み込んだモデルをメモリから外す操作です。lmsのロード・推定・解除
ランタイム更新の公式例は、GGUF側がlms runtime update llama.cpp、MLX側がlms runtime update mlxです。使う側を確認して更新し、変更後の版を記録します。ランタイム更新
Qwen3.5の対応を確認できない場合には、旧アーキテクチャのQwen/にあるQwen3-(約2.5GB)を別候補として検討できます。Qwen3の作者文書はllama.cpp b5401以上を推奨していますが、この版条件は旧Qwen3のもので、Qwen3.5の対応条件には流用できません。旧Qwen3-4Bのファイル、Qwen3の実行条件
補足:Ollamaを選ぶ場合
OllamaもMacで使う実行アプリです。調査時のリリースは0.34.0、公式Mac条件はmacOS 14以降で、Apple MシリーズではCPU/GPUに対応するとしています。Macへの導入案内、0.34.0リリース
CLIでの開始例はollama run qwen3.5:4bです。未取得ならダウンロードを伴います。このタグは約3.4GBのQ4_K_Mという表示で、上のbartowskiファイルとは別配布です。CLIの使い方、Ollamaの対象タグ
試す文脈を固定する場合は、会話内で/と設定し、別ターミナルのollama psでCONTEXTとPROCESSORを確認します。公式文書間で既定文脈長の説明が異なるため、ここでは既定値を前提にしません。Ollama FAQ、文脈長の説明
モデルを止める操作はollama stop qwen3.5:4b、保存ファイルの削除はollama rm qwen3.5:4bです。必要な操作を選び、Ollamaアプリ自体の終了とも分けて扱います。Ollamaの管理コマンド
8. 保存先と使い方を整える。
外付けSSDは、モデルの置き場として考える
モデルを増やすと、SSDの保存容量も必要になります。4章の4ファイルを一つずつ保存した場合、掲示容量の合計は3.01+6.17+19.00+22.29=50.47GBです。丸められたファイルサイズの合計で、画像用補助、別形式、ダウンロードや移行中の二重保存、アプリ、OSなどは含めていません。4B、9B、27B、35B-A3B
モデルの保管が容量増加の主な理由なら、外付けSSDを保存先にする方法があります。LM StudioはMy Modelsでモデルディレクトリを変更できます。接続したSSDに読み書きできるフォルダを用意し、保存先を選んだ後、対象フォルダとモデル一覧を確認します。保存先を選ぶことと、既存ファイルがすべて移動したことは分けて確認してください。モデル保存先の変更
OllamaはOLLAMA_MODELSで保存先を指定できます。Macアプリではlaunchctlで環境変数を設定してアプリを再起動する方式が案内されています。シェルで設定した値が、起動済みのアプリにも伝わると考えないようにします。既存ファイルのコピーも別作業です。Ollamaの保存先とMacアプリの設定
モデル保存、読み込み、スワップは別の話
| 段階 | SSDの役割 |
|---|---|
| モデルを保管する | 重みや関連ファイルを保存する |
| 初回ロード・モデル切替 | 保存先からデータを読む。SSD・接続・ファイルキャッシュの条件が関わる |
| 入力処理・生成 | 実装によってキャッシュやページの読み書きが介在する |
| メモリが圧迫される | macOSが起動ディスクのスワップ領域を使う |
表が収まらない場合は、横にスクロールできます。
たとえばLM Studioのmlx-engine 1.8.5には、入力処理・生成中のKVキャッシュをディスクへ書き、一時ファイルを/へ置く実装の説明があります。生成中にSSDが一切使われないとは限りません。mlx-engineのディスクキャッシュ
外付けへモデル保存先を変えても、MacのRAMやGPUの常駐予算は増えず、起動ディスク上のスワップの移動にもなりません。モデルフォルダ、会話履歴、ランタイムの一時領域は、それぞれの保存先を確認します。macOSのスワップ、モデル保存先、履歴管理
保管する棚SSDの保存容量のたとえ
使うための机実行中のメモリのたとえ
保存先を増やしても、RAMは増えない。
棚と机は、保存する量と作業に使う領域を分けて考えるためのたとえです。実際の転送やスワップの仕組みは、この図で表していません。AI生成の概念CG
購入時は、必要なRAMを先に考えたうえで、OS、普段のファイル、アプリ、一時領域に使う内蔵SSDの容量も見積もります。外付けの接続と管理を受け入れられるなら、モデルの保管を分ける。この順なら、内蔵SSDを最小にする前提で容量不足を先送りせずに選べます。
重くなったら、症状ごとに見る
以下は文献に基づく切り分け案です。設定を一つずつ変え、短い入力・一つの会話に戻して比べます。
| 症状 | 先に確認すること | 次の行動 |
|---|---|---|
| ロードできない | ファイルと形式、対応ランタイム、空きSSD、推定メモリ、エラー | 対応状況を照合し、小さいモデル・短い文脈で分けて確認する |
| 最初に開くときだけ待つ | ロード済みか、内蔵/外付けの保存先、初回か再読み込みか | 同じ条件のロードを比較する |
| 長い入力の後に待つ | 入力の長さ、prefill、思考設定 | 短い原文と比較する |
| 回答が空・思考の途中で終わる | Thinkingの実効設定、出力上限、テンプレート | 設定を照合する。上限を増やすだけで原因解消と決めない |
| 会話を伸ばすと重い・落ちる | メモリプレッシャー、圧縮、スワップの増分 | 新しい会話、文脈縮小、不要なモデル・アプリの終了を順に試す |
| 文章の伸びが遅い | モデル、量子化、GPUへの割り当て、ランタイム | 同じ課題・設定で候補を比較する |
| 保存容量が減る | 複数量子化、GGUFとMLXの重複、補助ファイル、履歴 | 保存先と対象ファイルを照合して管理する |
表が収まらない場合は、横にスクロールできます。
ロード・推定はLM Studio文書、待ち時間は推論解説、Thinkingはモデル設定、メモリはアクティビティモニタ、実行状況はOllama FAQに基づきます。
メモリプレッシャーは、macOSのメモリがどれくらい圧迫されているかを見る指標です。圧縮やスワップも併せて、実行前後、会話を伸ばしたときの変化を見ます。スワップの表示があることだけで、遅さの原因を一つに決めることはできません。Appleのメモリ使用状況ガイド
履歴と外部機能を、使い方に合わせて確認する
LM Studioはローカルの会話履歴を端末内に保存すると説明し、チャットのReveal in Finderから保存先を確認する方法を案内しています。バックアップや同期を使う場合は、そのフォルダが対象になっているかも確認します。提供者のプライバシー説明、履歴の保存先
OllamaにはCloud機能を無効化する設定があり、公式FAQは設定後の再起動とログでの確認を案内しています。ローカルモデルの選択に加え、必要な機能と接続範囲を確認して運用します。Cloudを無効化する設定
APIサーバーは、ほかのアプリからモデルを呼び出す入口です。自分のMacでチャットする最初の段階では、LANへ公開する必要はありません。使う場合は認証とアクセスできる範囲を確認します。LM StudioのAPI認証は公式文書では既定OFFとされているため、サーバーを開く操作だけで認証も有効になるとは考えないでください。API認証、ネットワークへの公開
最初の一つが、次の構成を選ぶ材料になる
まず、自分が整理したい短い文章を一つ用意します。選んだモデルで、内容、待ち時間、メモリの負担をそれぞれ確かめてください。
その結果があれば、モデルを変えたいのか、長い文脈が必要なのか、同時に使う作業を減らせるのかが見えてきます。Mac miniの容量やProへの追加費用も、そこで必要になった条件に結び付けて考えられます。